Warum ich den Chunk in meinem RAG-System auf 1500 Tokens gesetzt habe
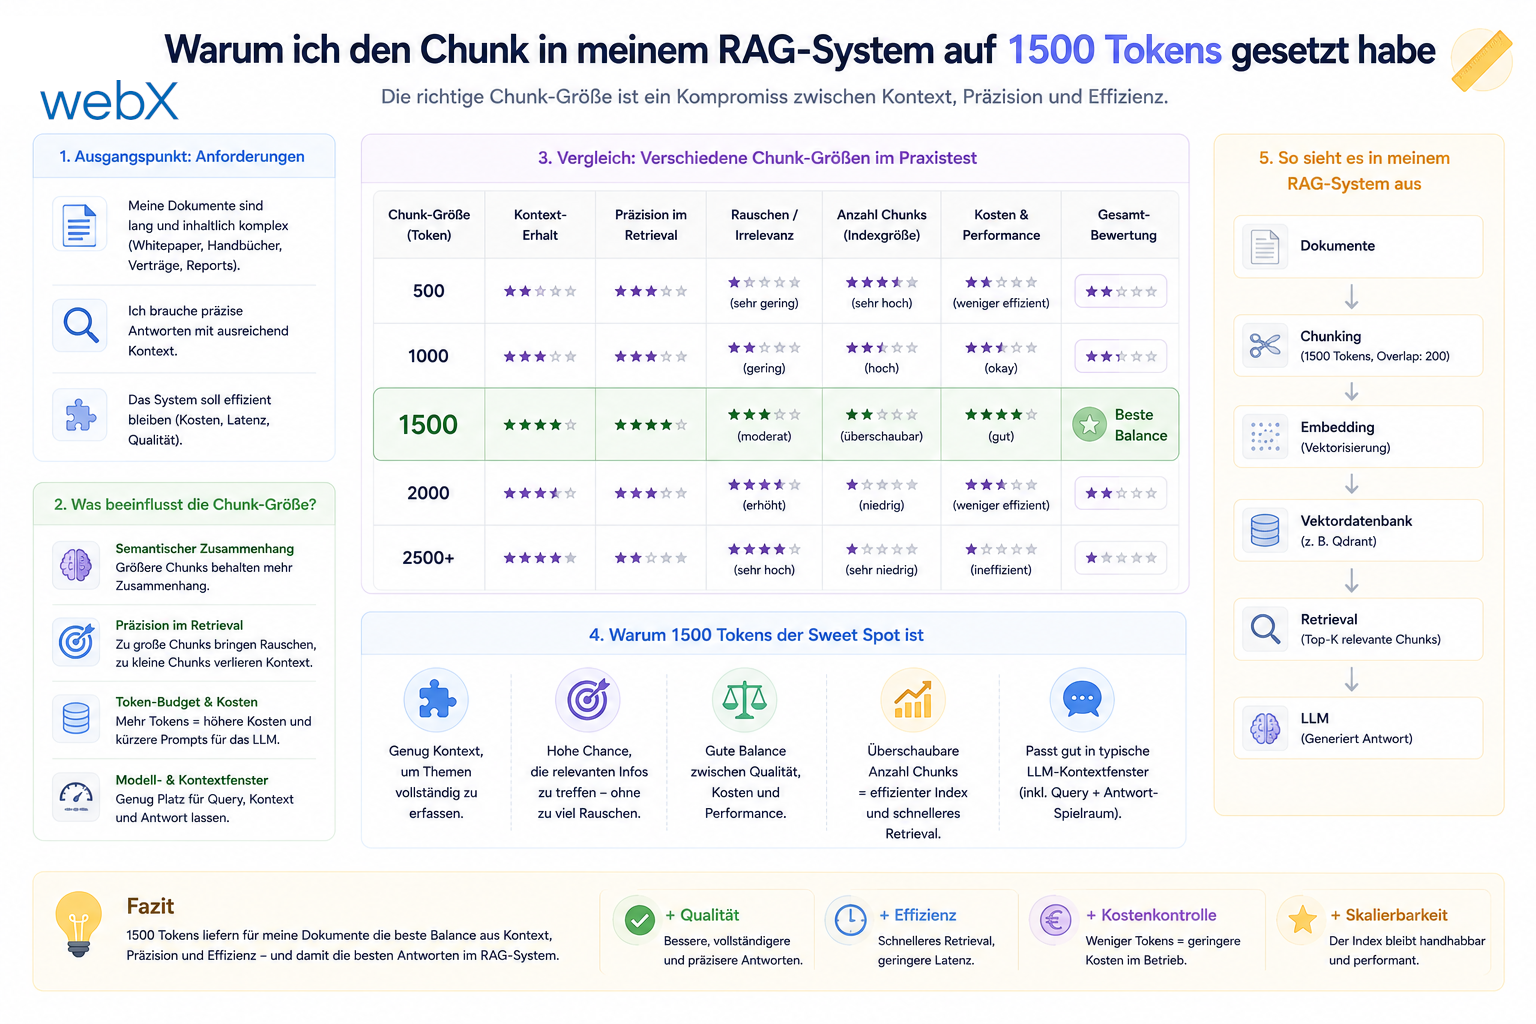
Die Migration auf bge-m3 brachte ein 8192 Tokens Limit. Dennoch habe ich das Chunk-Limit bewusst auf 1500 Tokens gesetzt, um die semantische Schärfe zu bewahren.
Inhalt
- Warum ich nicht bis an die Grenze von 8192 Tokens gegangen bin
- Warum 1500 Tokens die optimale Arbeitsgröße sind
- Was mir die neuen Ingest-Logs zeigen
- Wie ich die Entscheidung absichere
- Alle Artikel der Serie
Warum ich nicht bis an die Grenze von 8192 Tokens gegangen bin
Mit der Migration unseres Embedding-Modells von mxbai-embed-large auf BAAI/bge-m3 hat sich die technische Ausgangslage grundlegend geändert. Statt mickriger 512 Tokens steht uns nun ein gigantischer Kontextrahmen von bis zu 8192 Tokens zur Verfügung.
Auf dem Papier klingt das verlockend: Warum nicht einfach jeden noch so langen Instagram-Beitrag oder LinkedIn-Post am Stück einbetten, ohne sich jemals wieder Gedanken über Segmentierung machen zu müssen?
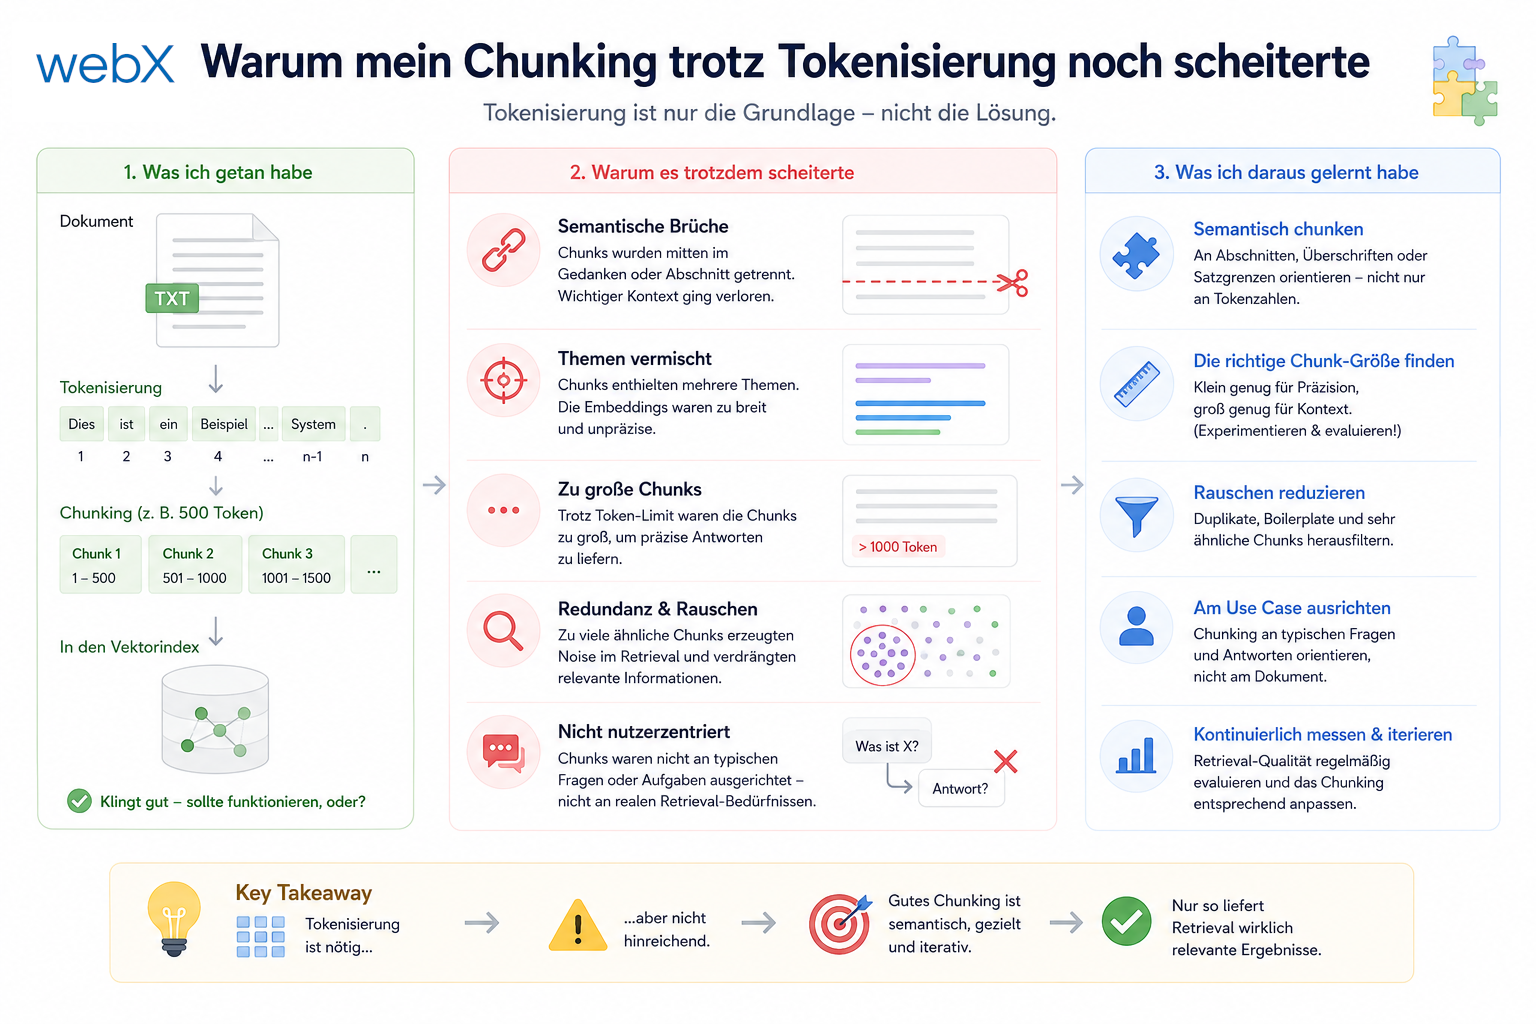
Ein einzelner Vektor muss die Aussagen eines Textes gemeinsam repräsentieren. Bei langen Texten mit mehreren Themen kann das die gezielte Suche nach einzelnen Abschnitten erschweren. Wie stark dieser Effekt ausfällt, hängt vom Modell, den Inhalten und den Suchanfragen ab.
Warum 1500 Tokens die optimale Arbeitsgröße sind
Ich habe für dieses Projekt eine Chunk-Größe von 1500 Tokens mit einem Overlap von 150 Tokens gewählt. Das ist eine Arbeitsannahme, kein durch einen Vergleichsbenchmark belegtes allgemeines Optimum. Dafür habe ich drei Gründe:
- Semantischer Fokus: Kleinere Textabschnitte sollen die Suche nach einzelnen Aussagen erleichtern. Ob 1500 Tokens dafür passend sind, muss ich mit repräsentativen Suchanfragen bewerten. Die Chunk-Größe allein garantiert keine bestimmte Suchqualität.
- Praktische Abdeckung: Texte innerhalb des Budgets können als ein Chunk verarbeitet werden. Längere Texte werden aufgeteilt. Für den Anteil ungeteilter Captions, OCR-Texte und Metadaten liegt hier keine dokumentierte Messreihe vor.
- Token-Budget: 1500 Inhaltstokens lassen unter dem angegebenen Modelllimit von 8192 Tokens rechnerisch Platz für zusätzlichen Input. Dieser Abstand ersetzt keine Prüfung des vollständigen Modellinputs einschließlich Special Tokens, Präfixen und Metadaten. Tokenizer, Modellversion und Server-Konfiguration müssen zusammenpassen.
Was mir die neuen Ingest-Logs zeigen
Der IngestWorker protokolliert die berechnete Token-Auslastung der Chunks. Im Node-Backend nutzen wir @xenova/transformers mit dem zum bge-m3-Modell gehörenden XLM-RoBERTa-Tokenizer. Diese Zählung ist nur dann mit dem Modellinput vergleichbar, wenn Tokenizer-Version, Vorverarbeitung und Special Tokens übereinstimmen.
// Real-time worker log showing the chunking execution
[IngestWorker] captureId abc | tokens=2145 chunks=2
[IngestWorker] captureId abc | chunk 1/2 contentTokens=1498/1500 modelTokens=1500/8192 (ok) chars=6234
[IngestWorker] captureId abc | chunk 2/2 contentTokens=647/1500 modelTokens=649/8192 (ok) chars=2811
Das gezeigte Log meldet für diese beiden Chunks Werte unter dem konfigurierten Limit. Das lokale (ok) dokumentiert die Budgetprüfung des Workers. Es ist kein allgemeiner Stabilitätsnachweis und belegt weder fehlerfreie Tokenisierung noch den Ausschluss aller API-Fehler.
Wie ich die Entscheidung absichere
Ich behandle die 1500 Tokens als überprüfbare Konfiguration. Bei Änderungen an Modell, Tokenizer, Präfixen oder Metadaten muss ich das vollständige Input-Budget erneut prüfen und die Suchqualität mit passenden Beispielen bewerten.
Die automatisierte Modellbereitstellung via Docker Compose und die Verarbeitung im Worker machen den Ablauf nachvollziehbar. Sie ersetzen diese Prüfungen nicht.
Alle Artikel der Serie
- Vision und Systemübersicht: Chrome Extension, RAG-Architektur, Projekthintergrund: Artikel lesen
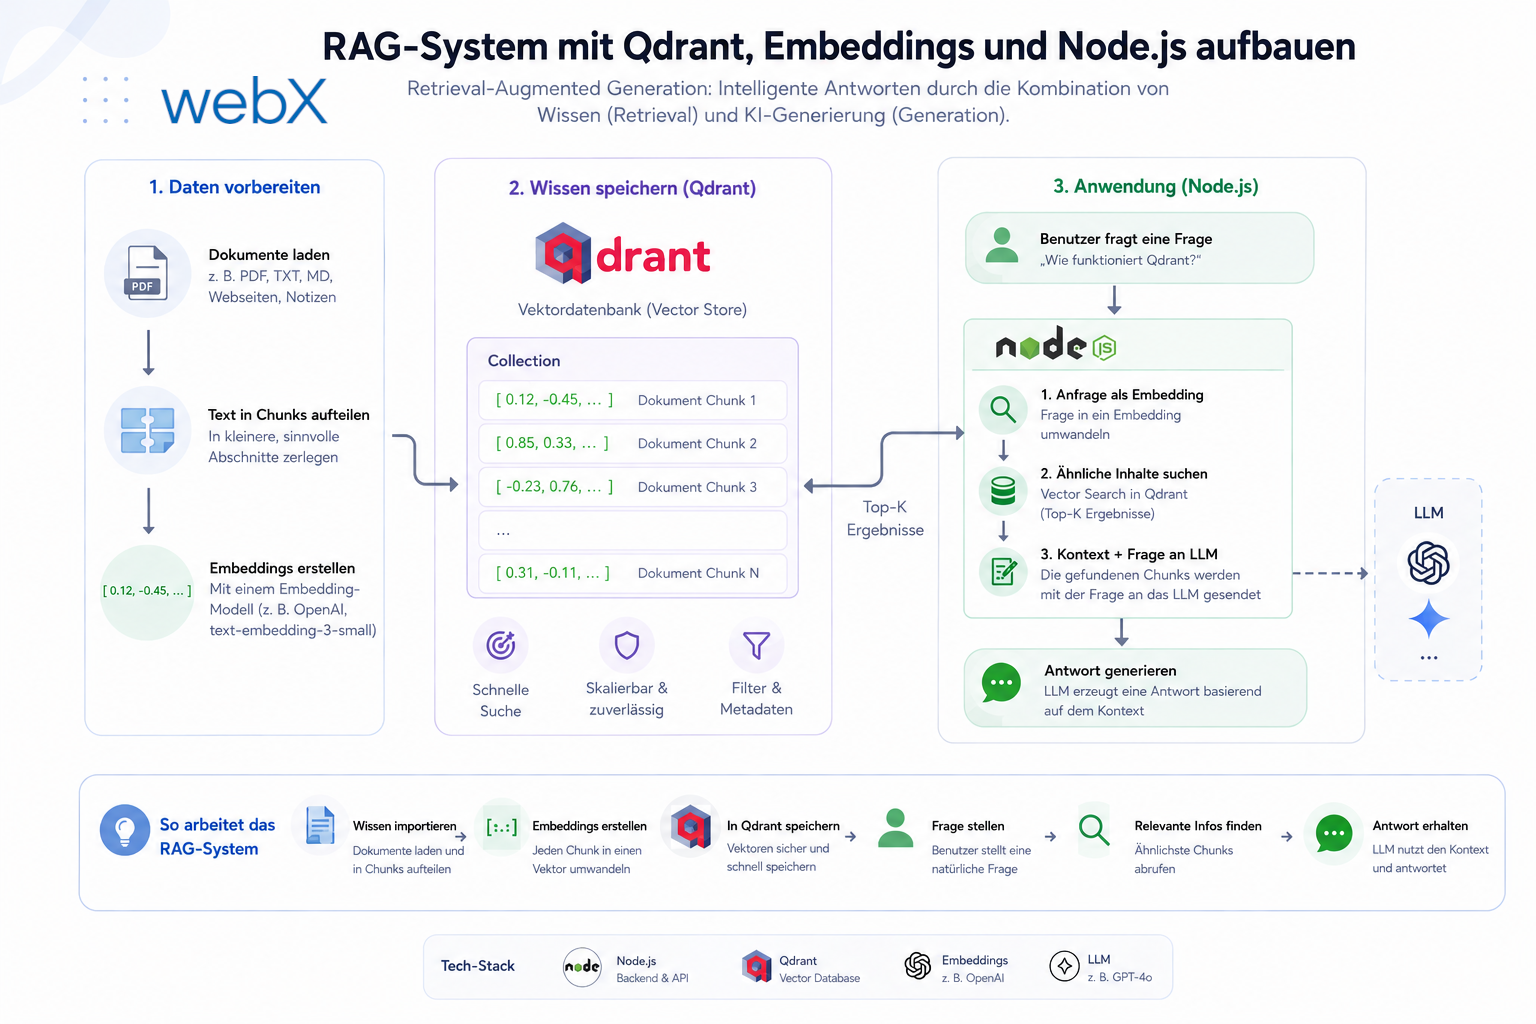
- RAG-System Aufbau: Qdrant, Embeddings, Cosine-Ähnlichkeit in TypeScript: Artikel lesen
- AI Provider Abstraktion: Ollama vs. OpenAI, Interface-Design, kein Vendor-Lock-in: Artikel lesen
- Chrome Extension MV3: Drei isolierte Laufzeitkontexte, Message Passing, Strategy Pattern: Artikel lesen
- Docker Compose Strategie: Override-Pattern, von lokal zu Azure: Artikel lesen
- Ollama lokal vs. Docker: Die Entscheidung und ihre Konsequenzen: Artikel lesen
- Ollama Auto-Pull Entrypoint: Automatisiertes Modell-Setup beim Container-Start: Artikel lesen
- tsconfig und Vite:
Node16vs.bundler, warum Vite eigene Regeln hat: Artikel lesen - Instagram Caption mit MutationObserver vollständig laden: Artikel lesen
- Chrome Extension Foundation mit Health-Dot und Retry-Queue: Artikel lesen
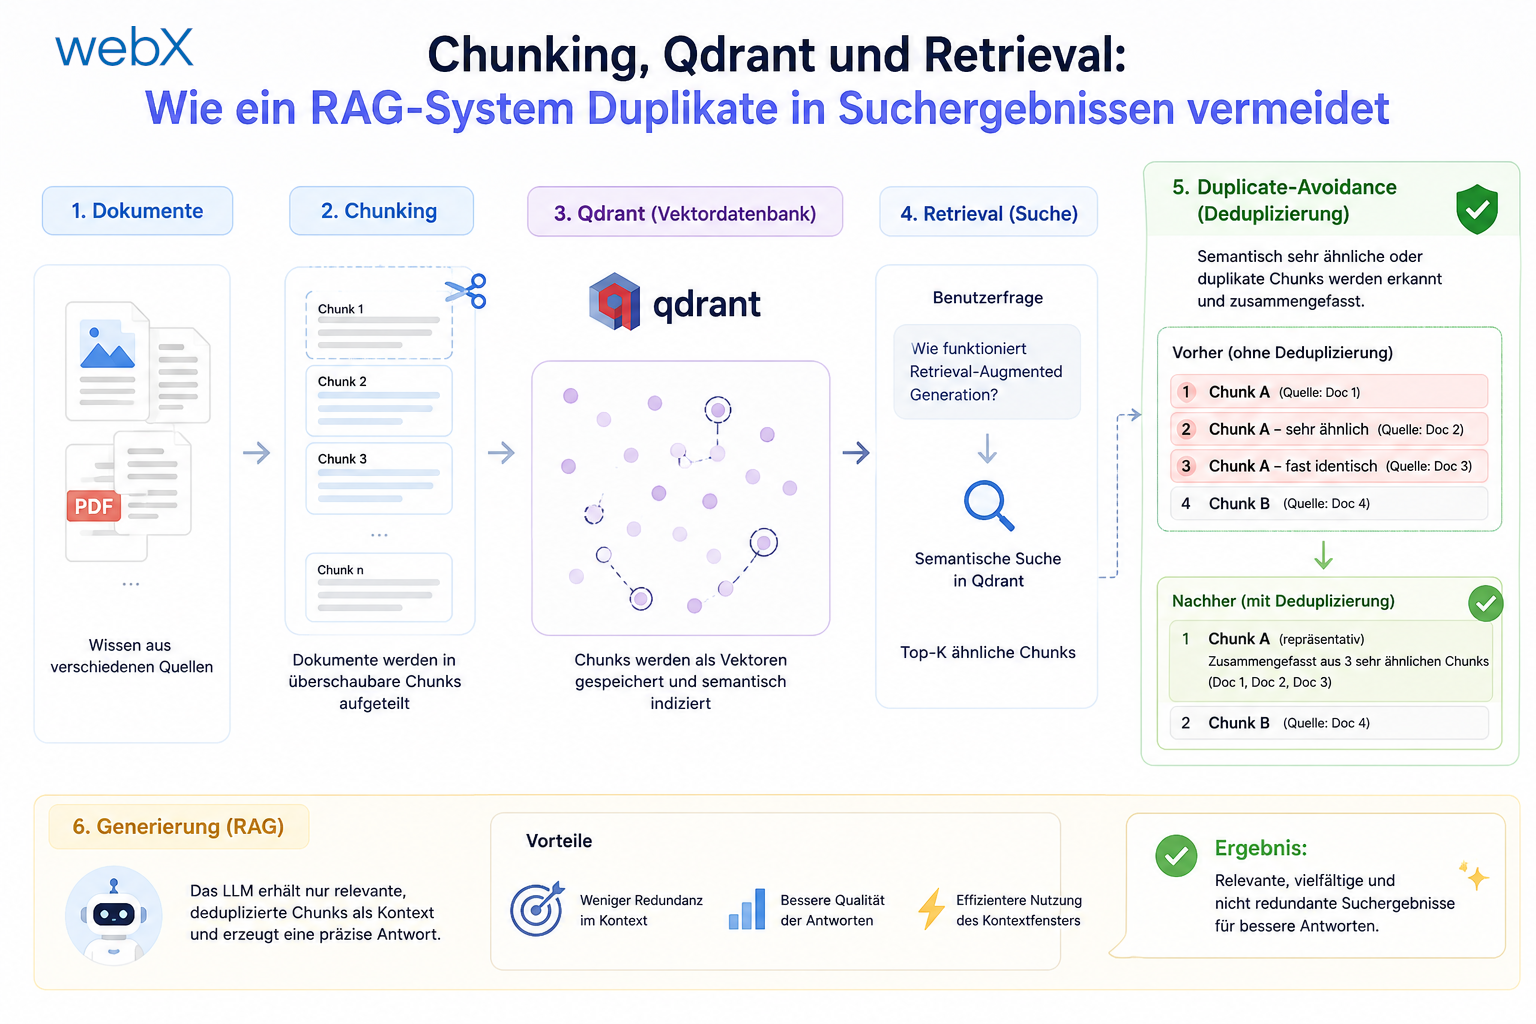
- Phase 2 Features: Shadow DOM Overlay, Tailwind v4, Duplicate Detection: Artikel lesen
- Race Condition bei der Plattformerkennung: Wie ein UI-Event die Instagram-Erkennung bricht: Artikel lesen
- PostId-Extraktion in zwei Instagram-Layouts: querySelector vs. Ancestor-Traversal: Artikel lesen
- Instagram Karussell vollständig erfassen mit MutationObserver: Lazy-Loading, Observer-before-click, Timeout-Fallback: Artikel lesen
- Notiz und Tags beim Screenshot-Speichern: Artikel lesen
- Instagram Tastatur-Shortcuts blockieren Chrome Extension Eingaben: Artikel lesen
- Lowercase-Normalisierung und Duplikat-Erkennung im Tag-Input: Artikel lesen
- Zitadel Login V2 in Docker Compose: drei versteckte Fehler: Artikel lesen
- PKCE OAuth in einer Chrome MV3 Extension: Artikel lesen
- React Frontend mit react-oidc-context und Zitadel: Artikel lesen
- Vite Build-Time-Umgebungsvariablen in Docker: Artikel lesen
- Event-Driven Ingestion mit BullMQ und Redis: Artikel lesen
- MinIO statt Azurite: S3-kompatible Objektspeicherung lokal und auf Hetzner: Artikel lesen
- access_token, id_token und der Userinfo-Endpoint: was wohin gehört: Artikel lesen
- Qdrant Multi-Tenancy: Pro Nutzer eine eigene Collection: Artikel lesen
- Wenn Backend und Frontend unterschiedliche Typen kennen: Artikel lesen
- Zitadel Bootstrap entfernt: Host-Header-Bug und manuelles Setup: Artikel lesen
- Backend Code Review: sechs Probleme vor dem Launch behoben: Artikel lesen
- Traefik statt NGINX: Reverse Proxy für einen wachsenden Docker-Compose-Stack: Artikel lesen
- Zweischichtiges Rate Limiting: Traefik und express-rate-limit mit Redis: Artikel lesen
- DSGVO Art. 17 korrekt implementieren: Promise.allSettled und Export-Batching: Artikel lesen
- Embedding-Modell-Lock-in: Warum mxbai-embed-large eine Produktionsentscheidung für immer ist: Artikel lesen
- Docker Volumes in Produktion: Named Volumes, Bind Mounts und der Hetzner-Volume-Trick: Artikel lesen
- Zwei Sicherheitslücken vor dem Launch: Redis ohne Auth und ein offener Qdrant-Admin-Port: Artikel lesen
- Traefik als einziger Einstiegspunkt im Docker Compose Stack: Artikel lesen
- Zitadel hinter Traefik richtig verdrahten mit Issuer, JWKS und Login V2: Artikel lesen
- Frontend reparieren wenn der nginx Healthcheck an localhost scheitert: Artikel lesen
- Observability für meinen Docker Compose Stack mit Bull Board und Dozzle: Artikel lesen
- Qdrant Dashboard sicher öffnen mit lokalem Traefik und SSH Tunnel: Artikel lesen
- Diagnose: Warum mein Chunking trotz Tokenisierung noch scheiterte: Artikel lesen
- Entscheidung: Warum ich den Chunk auf 1500 Tokens gesetzt habe: (dieser Artikel)
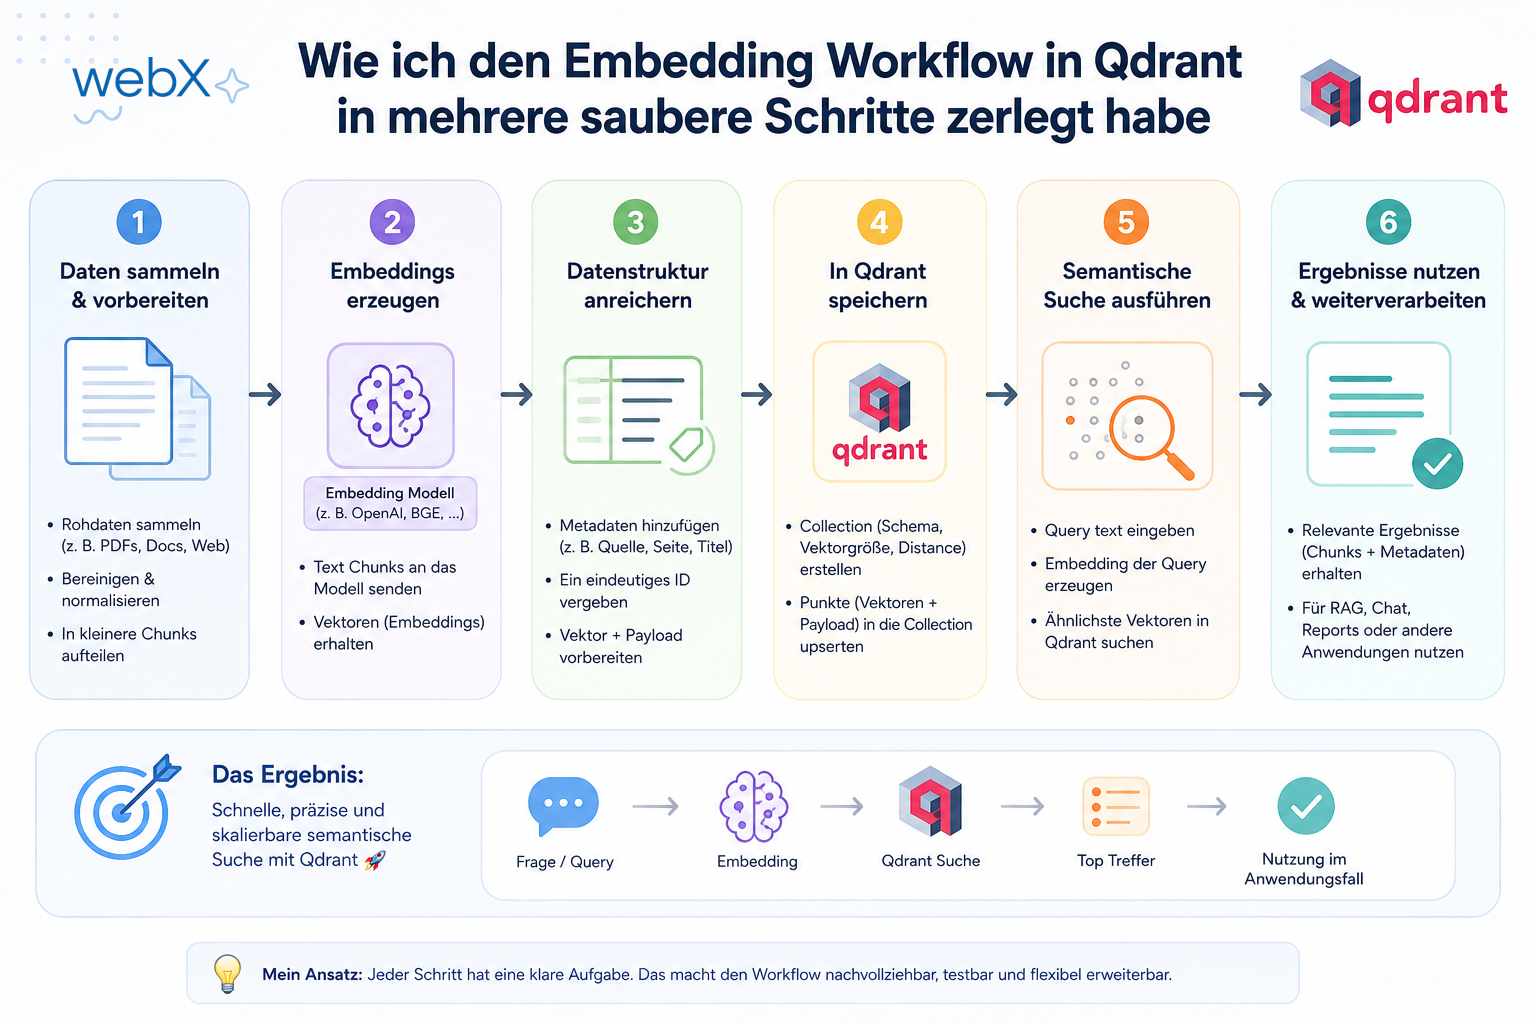
- Implementierung: Wie ich den Embedding Workflow in mehrere saubere Schritte zerlegt habe: Artikel lesen
- Validierung: Wie ich Chunking, Speicherung und Suche wieder zusammenbringe: Artikel lesen
- ‘Capture Intake als eigenes Modul, weniger Orchestrierung im Express Endpoint’: Artikel lesen
Du baust gerade ein ähnliches System und willst die gleiche Struktur für dein Projekt bewerten? Lass uns das gemeinsam einschätzen.